


Google Gemini是由谷歌推出的一款人工智能多模态大模型,于2023年12月6日发布。这个模型具有强大的功能,能够同时识别文本、图像、音频、视频和代码五种类型的信息。它还能理解并生成主流编程语言的高质量代码,如Python、Java、C++,并且进行了全面的安全性评估。这个模型标志着人工智能领域的一个重大突破,因为它不仅能够处理文本信息,还能理解图像、音频、视频和代码等多种类型的数据。Gemini模型分为三种规模:Ultra、Pro和Nano,适用于从大型数据中心到移动设备的各种场景。
Gemini Ultra 是最强大的版本,它在32个广泛使用的学术基准中的30个上超过了当前最先进的模型,如GPT-4。特别是在MMLU(大规模多任务语言理解)上,Gemini Ultra的得分高达90.0%,成为第一个在该领域超越人类专家的模型。它还能够生成世界上最流行的编程语言(如Python、Java、C++和Go)的高质量代码,并且在AlphaCode 2系统中表现出色,解决的问题数量几乎是原来的两倍。
Gemini Pro 是针对日常使用优化的版本,它已经集成到Google的对话模型Bard中,提升了其在高级推理、规划、理解等方面的能力。而Gemini Nano 则是设计用于嵌入到移动设备中的版本,它通过从更大的模型中提取精华训练,并以4位量化部署,适用于低内存和高内存设备。
Gemini模型的训练数据集既多模态又多语言,前期训练数据集使用来自网络文档、书籍和代码的数据,包括图像、音频和视频数据。谷歌使用SentencePiece分词器进行训练,并发现在整个训练语料库的大样本上训练分词器可以改善推断出的词汇表,进而提高模型性能。此外,谷歌对所有数据集应用质量过滤器,去除有害内容,确保模型的安全性和可靠性。
Gemini模型的设计初衷是作为一种本质上的多模态模型,可以从一开始就同时处理和理解包括文本、代码、音频、图像和视频在内的不同类型的信息。这使得它在发现大量数据中难以辨别的知识方面具有独特的能力。目前,Gemini Ultra正在完成广泛的信任和安全检查,预计将在未来向开发人员和企业客户推出。
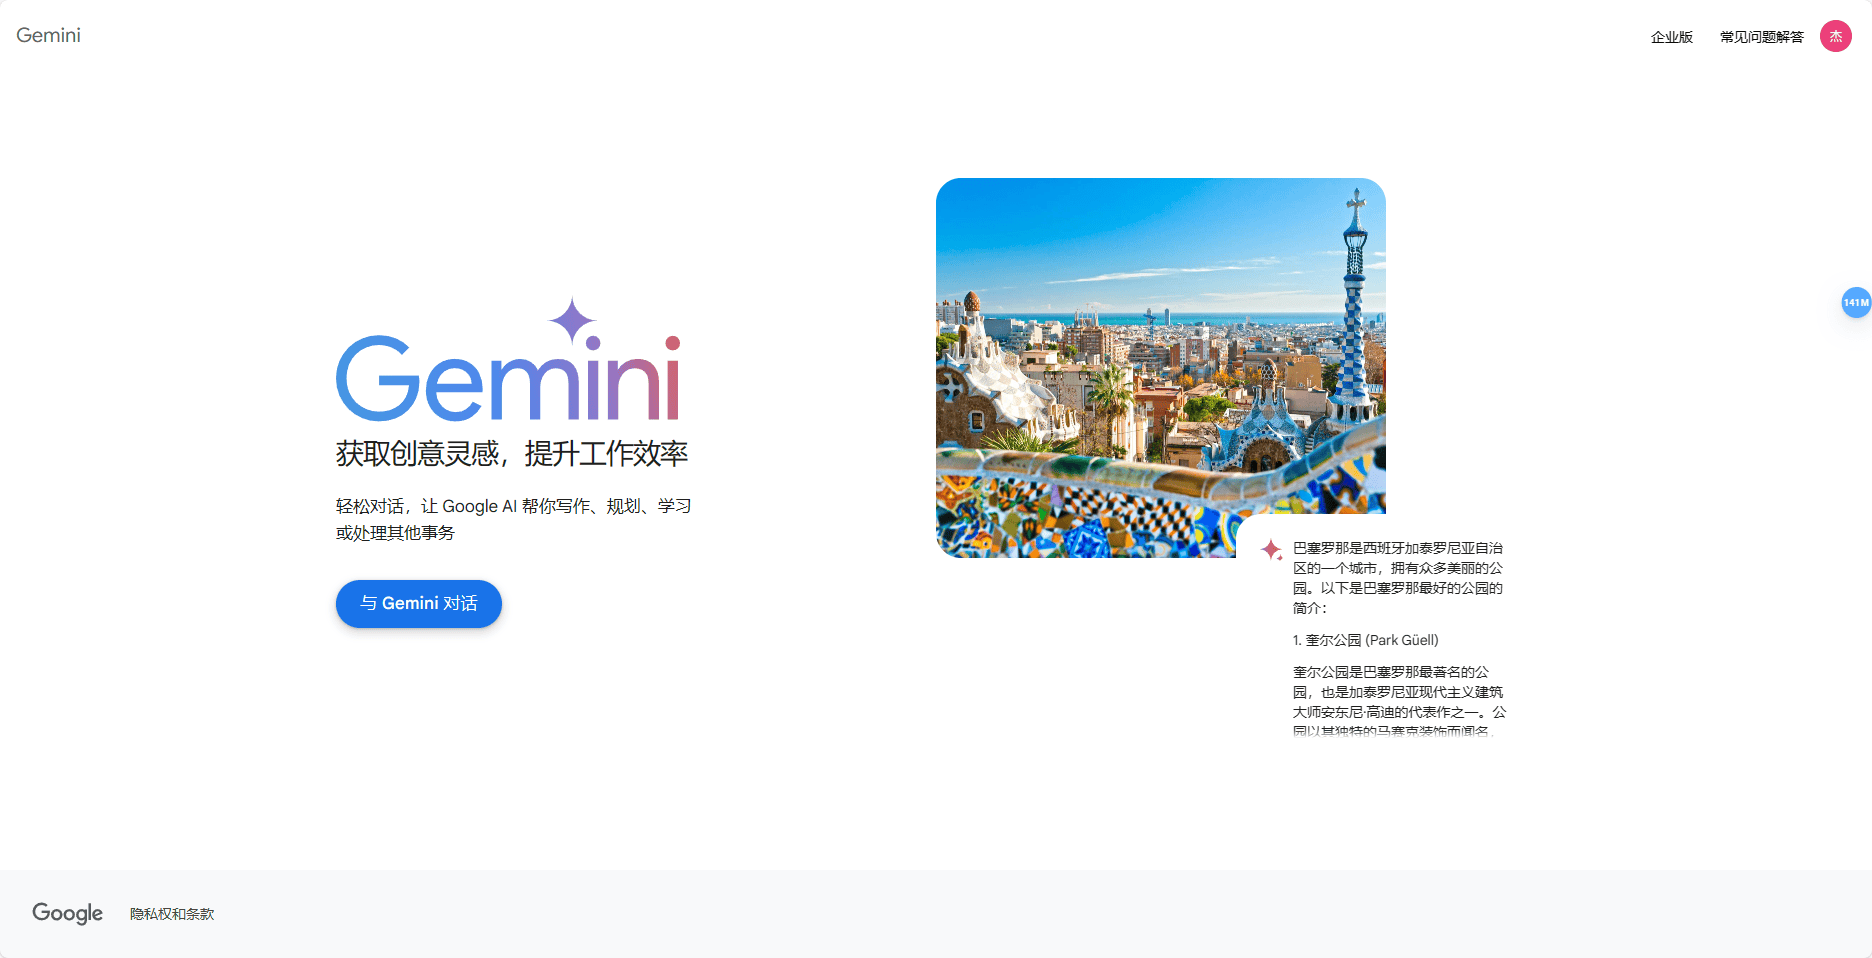 Gemini的功能特色
如果您需要获取Google Gemini的API key,可以在官网点击“Get API Key”,然后按照指示操作来获取您的API Key。
Google Gemini最新使用视频教程:
https://img.pidoutv.com/wp-content/uploads/2024/03/1437005340-1-16.mp4如果你经常无法打开「Google Gemini」,通常有以下三种原因,对应三种解法:
软件屏蔽:微信、QQ 等软件可能默认屏蔽部分站点。请复制网址到手机自带浏览器打开,不要用微信 / QQ 的内置浏览器。
浏览器问题:提示「网站违规」并不代表站点真的违规,多来自浏览器厂商的屏蔽策略。建议换用原生浏览器(苹果 Safari、微软 Edge),或独立开发的浏览器(Alook、X 浏览器、VIA 等)。
网络问题:网络不稳定、或所用运营商对该站点未做优化,也会打不开。可切换网络环境后重试;部分境外服务还需在符合当地法律法规的前提下访问。
以上三步基本能解决绝大多数打不开的情况。仍然不行,多半是该站点已停止服务或换了域名 —— 可在 站内搜索 找同类替代品。
仍打不开、或发现信息过期,反馈给管理员 即可,核实后会及时更正或下架。
特别声明
- 本站所提供的「Google Gemini」站点内容均来源于网络,不保证外部链接的准确性与完整性;对于该外部链接的指向,不由本站实际控制。
- 在 2024-09-03 12:14:57 收录时,该站点的内容均属合规合法。后期该站点如出现违规,可直接联系管理员删除,本站不承担任何责任。


